Kan AI läsa gamla handskrifter?
Har du någon gång suttit med en dombok från 1600-talet och undrat om AI kunde läsa den åt dig? Det har jag. Och svaret är ja! Men det spelar enormt stor roll vilken AI du väljer. Den bästa läser nästan nio av tio bokstäver rätt i en snårig 1600-talshandstil. Den sämsta får knappt en bokstav rätt i samma text...
För att ta reda på hur det faktiskt står till har jag byggt ett eget test, som jag kallar Handskriftskampen. Där har jag låtit tretton olika AI-modeller och transkriberingsverktyg tävla om att läsa samma svenska handskrifter.
Så gick testet till
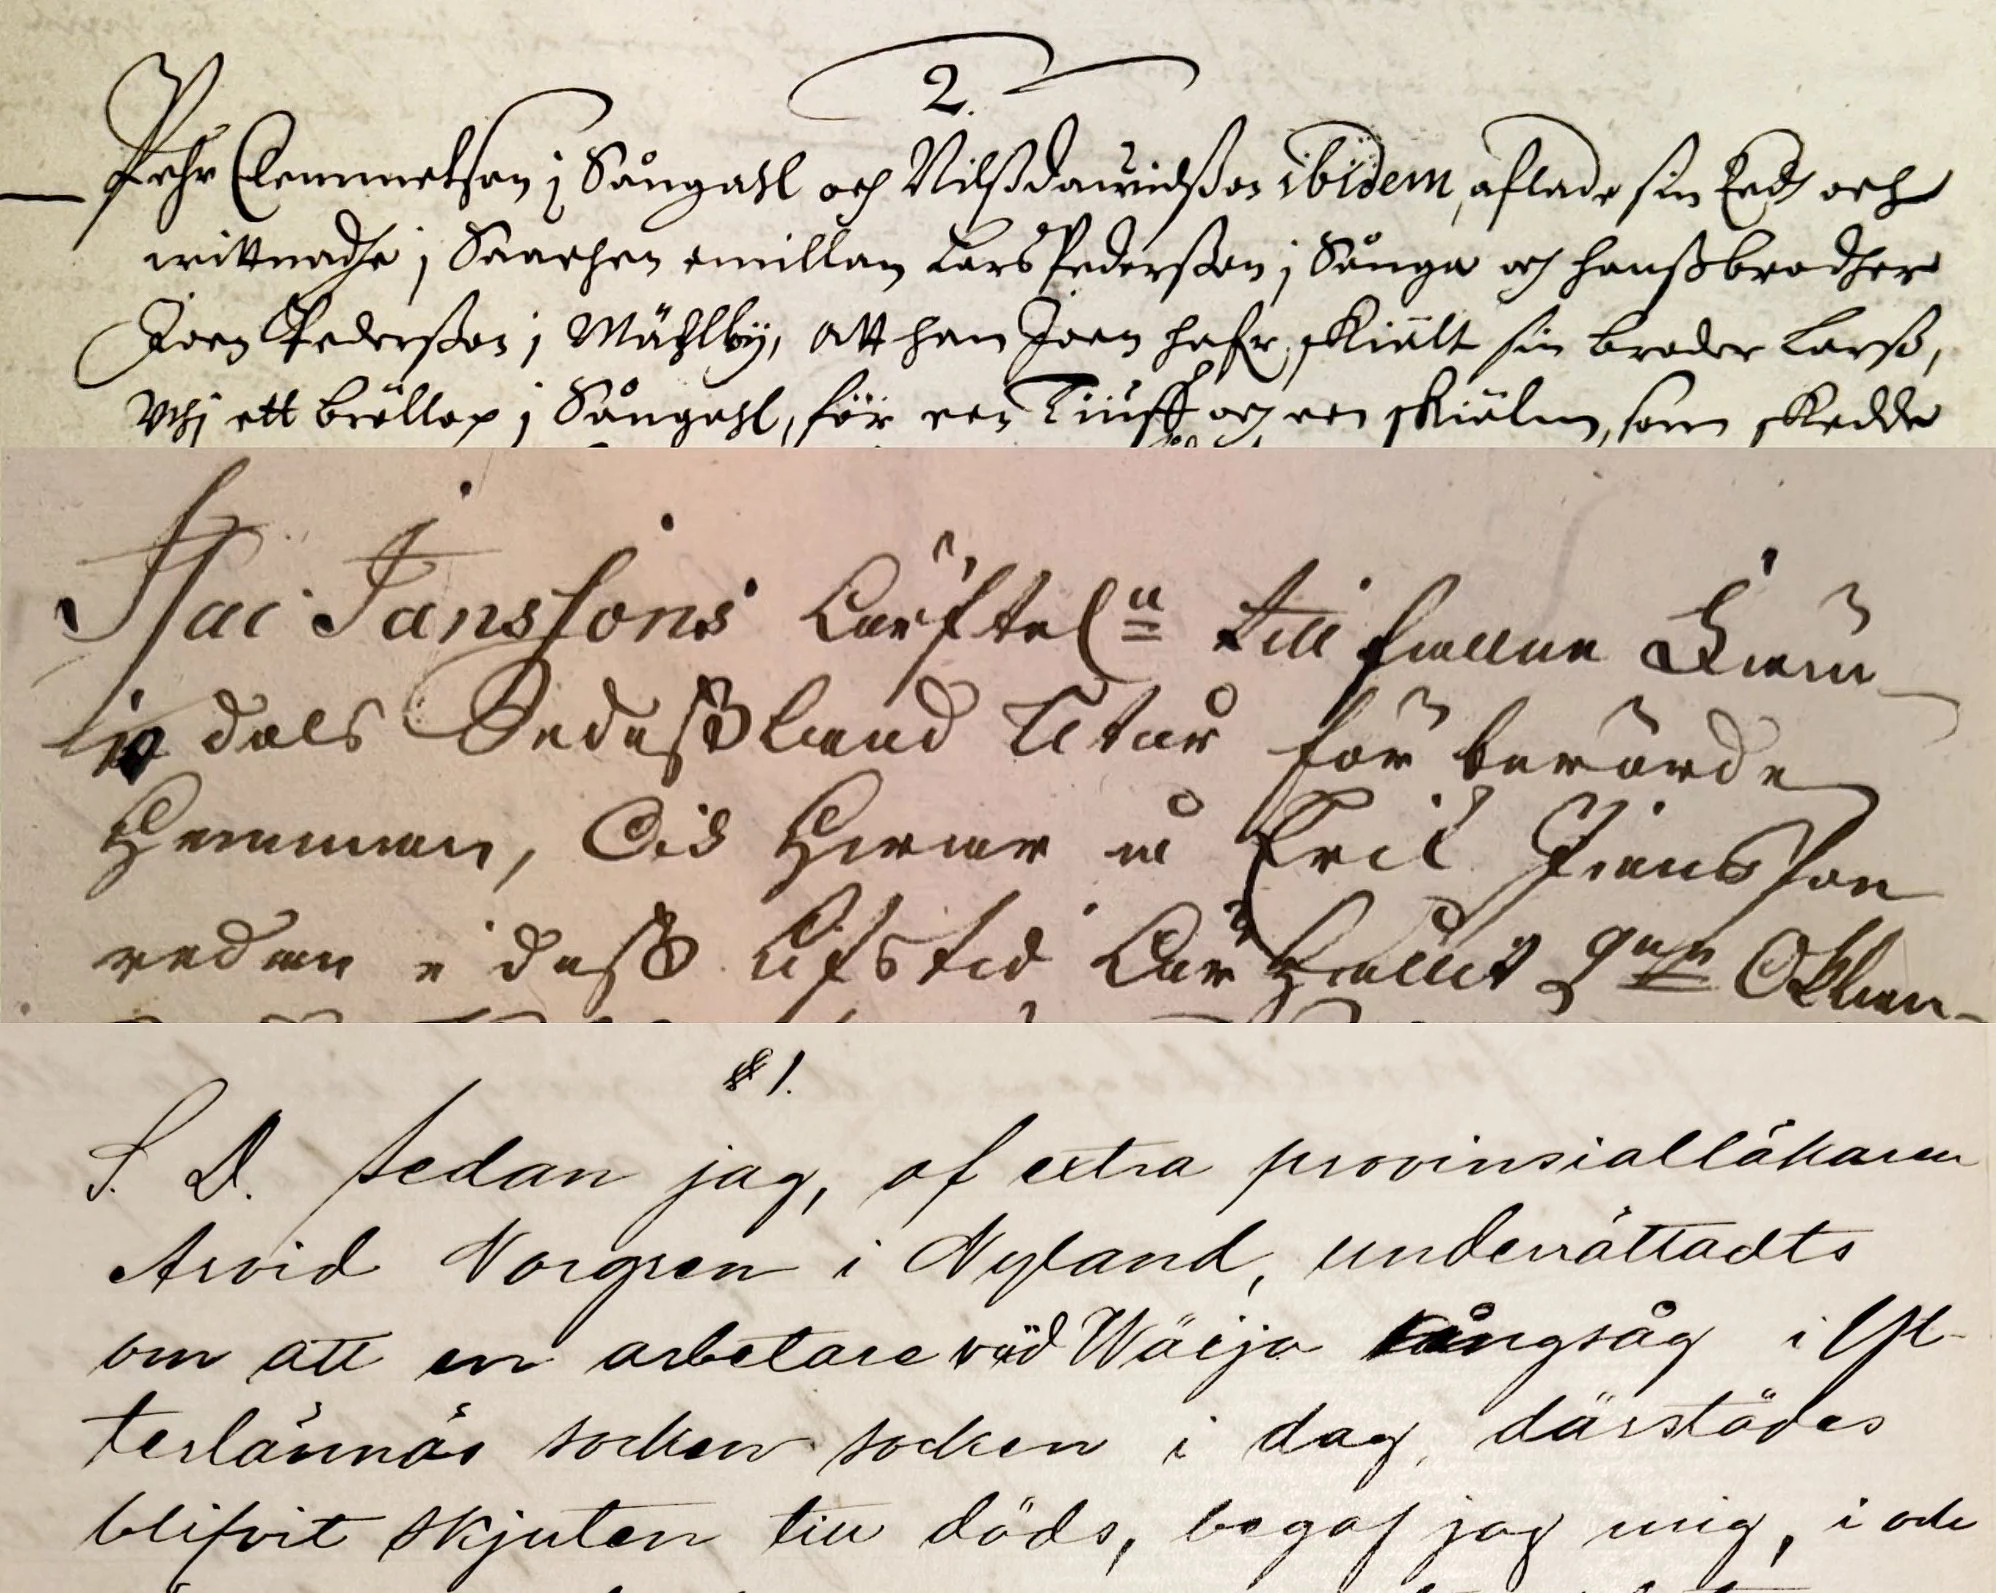
Jag valde tre dokument med löpande text från tre olika tider: ett domboksprotokoll från 1677, ett protokoll från 1783 och en polisrapport från 1907. Alla tre har jag först transkriberat själv, ord för ord, bokstav för bokstav. Min egen transkribering blir facit, alltså det svar som modellerna jämförs med.
Sedan fick varje modell läsa samma bild, och deras text jämfördes bokstav för bokstav med facit. De som arbetar med tolkning av handskrifter brukar mäta det med något som kallas teckenfelfrekvens. Det är helt enkelt hur stor andel av bokstäverna som blivit fel, saknas eller lagts till i onödan. Jag har gjort om det till en poäng mellan 0 och 100, där 100 betyder att varje tecken blev rätt.
Testet är strängt. Skriver modellen "Eed" när det står "Eedh" räknas det som fel, precis som när den moderniserar "wara" till "vara". Det är ju just den gamla stavningen vi släktforskare vill få fram. Radbrytningar och utfyllnadsstreck som "- - - -" räknas däremot inte.
Vad testerna visar
Föga överraskande vinner de verktyg som är specialbyggda just för äldre handskrifter. Men en spännande upptäckt är att en av de generella AI-modellerna nu är hack i häl på äldre handskrift! Med text från tidigt 1900-tal jämnas dock skillnaderna ut och nästan alla modeller läser bra.
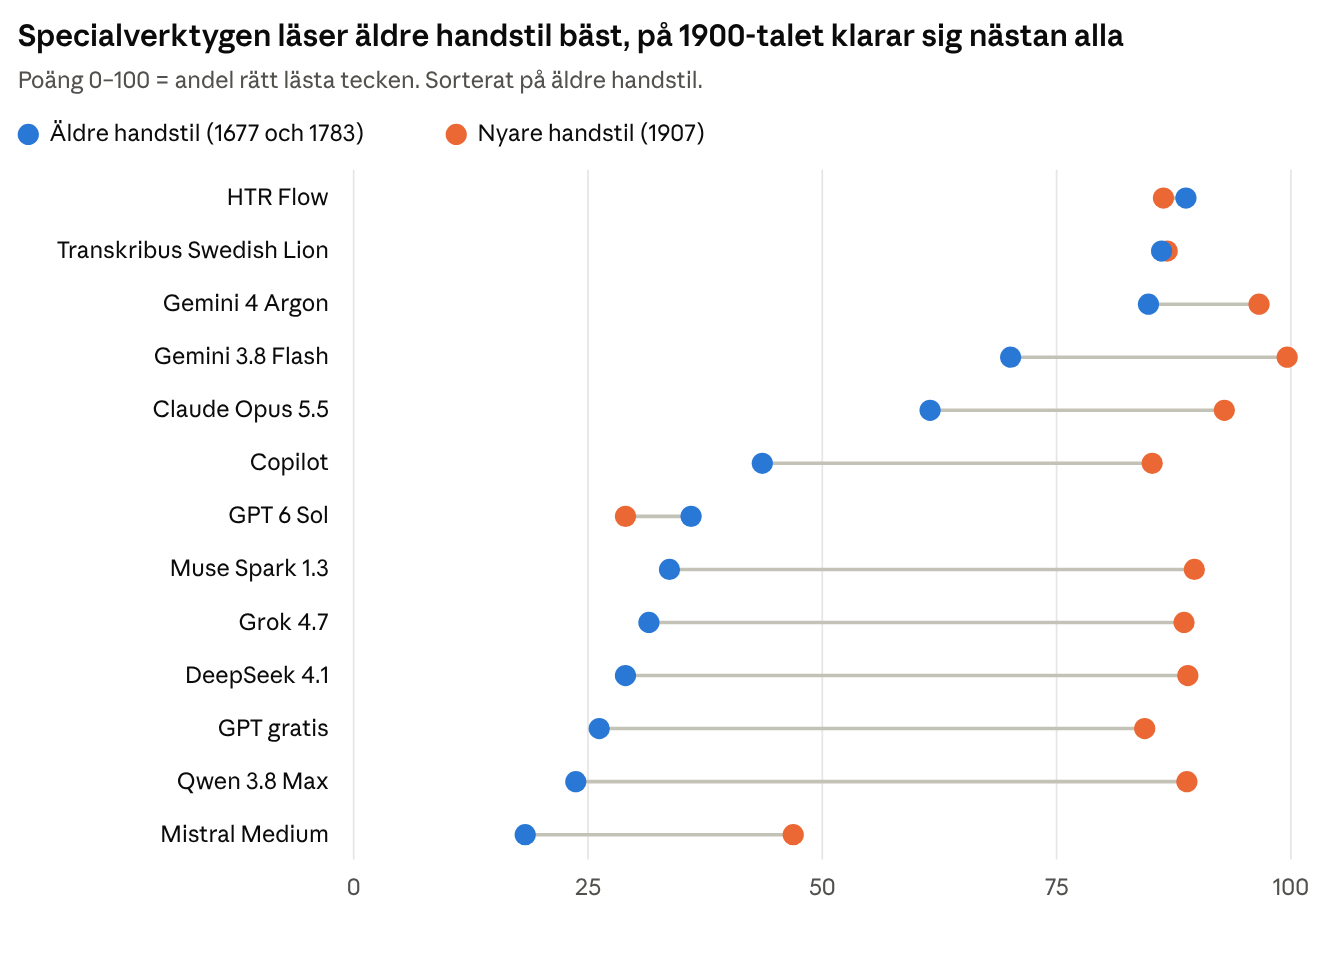
AI-verktygens score för transkribering av handskrifter (oktober 2026).
I toppen är det riktigt jämnt. Googles Gemini 4 Argon, Riksarkivets HTR Flow och Transkribus med modellen Swedish Lion skiljer sig bara ett par poäng åt över alla tre dokumenten. Men de vinner på olika sätt. HTR Flow och Transkribus läser 1600- och 1700-talet allra säkrast och håller nästan exakt samma nivå oavsett ålder på texten. Gemini 4 Argon är aningen svagare på de äldsta handskrifterna men läser 1907 nästan felfritt.
Mest tydligt är hur stor klyftan är för de vanliga chattbottarna. Gemini 3.8 Flash läser polisprotokollet från 1907 i stort sett utan ett enda fel, men tappar nästan en tredjedel av bokstäverna i 1600-talstexten. Flera av de mest kända AI-tjänsterna, som Copilot, Grok, DeepSeek och gratisversionen av ChatGPT, läser 1907 helt godkänt men får bara mellan en fjärdedel och en tredjedel av de äldre texterna rätt.
Och så finns det några udda fåglar. GPT 6 Sol är den enda modellen som av någon anledning läser den nyare texten sämre än den gamla. Förklaringen är att den i 1907 års protokoll skriver "[oläsligt]" om och om igen och hoppar över stora delar av texten. Det är ärligt, men det ger inte mycket att arbeta med. I 1600-talstexten gör den tvärtom och fyller i med ord som låter rimliga men inte alls finns i texten.
Mistral Medium hamnar sist i båda grupperna. Den gissar friskt, och i polisprotokollet blir "gevärskott" plötsligt en "glasmästare". Det är just den sortens fel som är farligast för en släktforskare, eftersom en påhittad text kan se lika trovärdig ut som en rätt läst.
Vad kan jag rekommendera i dag?
Mitt korta svar är: välj verktyg efter hur gammal texten är, och lita aldrig blint på resultatet.
Har du texter från 1600- och 1700-talet? Börja med Riksarkivets HTR Flow eller Transkribus med modellen Swedish Lion. De är tränade på svenska arkivhandskrifter och läser de gamla handstilarna säkrast i mitt test. Men de är samtidigt byggda för att hantera ett begränsat antal sidor per dag (om du inte installerar HTR Flow i en egen datormiljö). Ett abonnemang på Google Gemini och modellen Gemini 4 Argon är ett bra alternativ om du hellre vill använda en vanlig AI-tjänst som är bra på det mesta.
Har du texter från sent 1800-tal eller 1900-tal? Här klarar sig flera modeller mycket bra. Google Gemini 3.8 Flash och Gemini 4 Argon läste polisprotokollet från 1907 nästan felfritt, och Claude Opus 5.5 var inte långt efter.
Använder du gratisversionen av en chattbot? Den fungerar hyfsat för nyare handstilar, men för äldre texter blir det tyvärr alldeles för många fel för att det ska vara till verklig hjälp.
Oavsett vilket verktyg du väljer: läs alltid igenom texten mot originalet, särskilt namn, gårdsnamn och årtal. Det är där ett fel får störst följder i släktträdet. En bra AI-transkribering är en utmärkt första läsning som sparar dig mycket tid, men det är fortfarande du som har sista ordet. Glöm aldrig att det är du som är släktforskaren - AI är din assistent!
Vad händer härnäst?
Ett viktigt förbehåll: tre dokument är ett litet underlag. Varje handstil har sina egenheter, och en modell kan råka vara bra på just en viss skrivare. Därför tänker jag fortsätta testa med fler äldre texter för de modeller som hamnade i toppen, för att följa tätstriden.
Hittills har jag bara testat document med löpande text. Kolumnerna i en husförhörslängd är en helt annan utmaning, där det inte räcker att läsa rätt. AI:n måste också hålla ordning på vilket namn, datum och vilken ort som hör ihop. Det blir ett eget test längre fram.
Vi lever i en spännande tid! Att läsa en dombok från 1600-talet har länge krävt år av övning. I dag finns det flera verktyg som klarar nästan nio av tio bokstäver på egen hand. Prova gärna själv med en sida som du redan har läst, så ser du snabbt hur långt tekniken har kommit.
Men… AI-hjälp i all ära… Det finns få saker som slår att själv få sitta och läsa i originalhandlingar på arkivet omgiven av en svag doft av arkivdamm! Fast det finns ju sååå mycket att läsa… Därför är det bra att kunna ta hjälp av en AI-assistent.
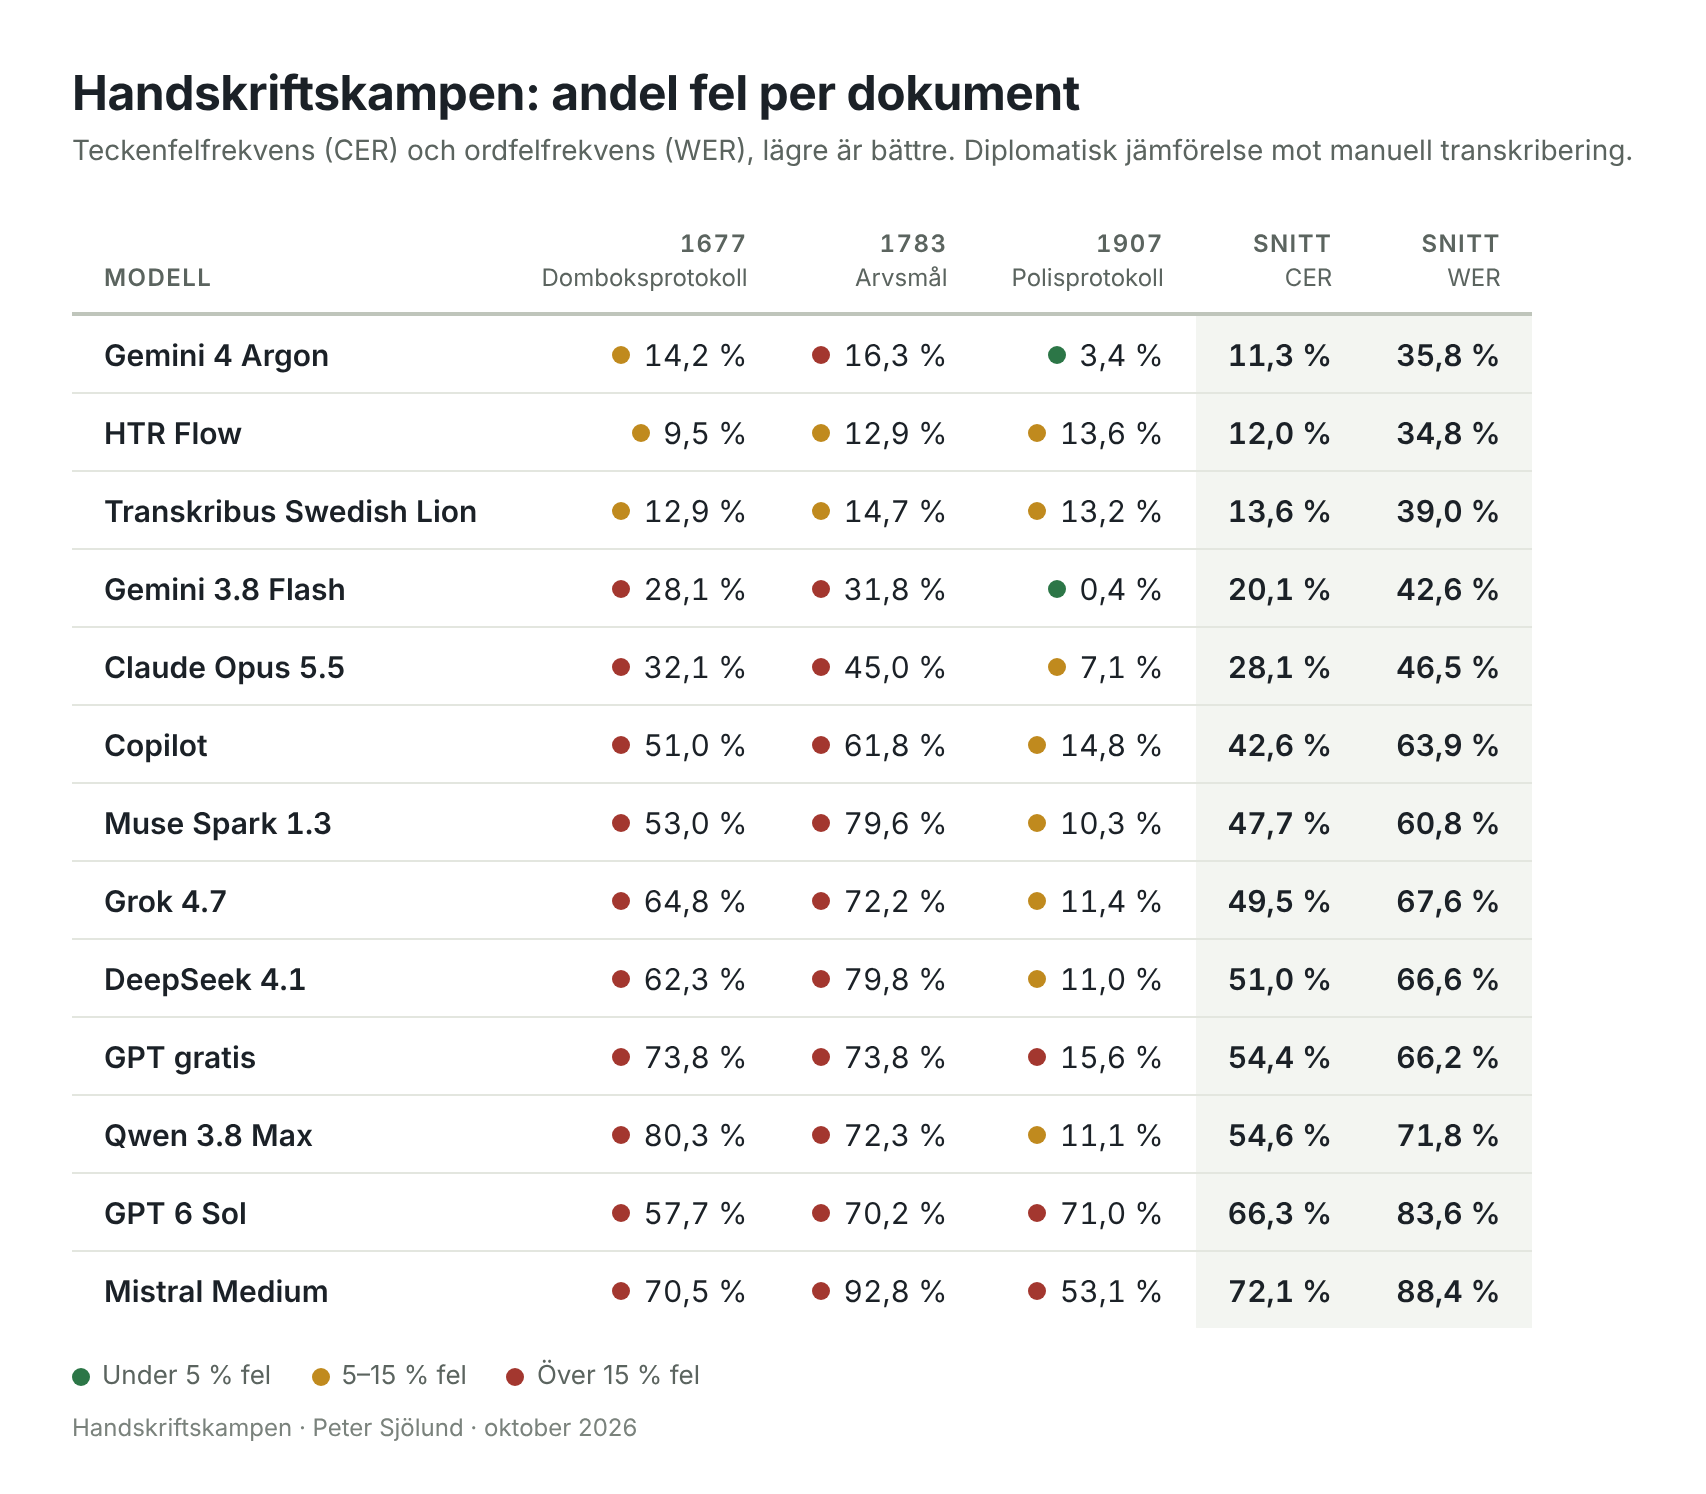
Här ser du de detaljerade resultaten av testet: